جداول وب سکریپینگ با استفاده از Pandas

جداول وب سکریپینگ با استفاده از Pandas
جداول وب سکریپینگ با استفاده از Pandas
کتابخانه Pandas در پایتون شامل تابعی به نام read_html() است که میتواند برای استخراج اطلاعات جدولی از هر صفحه وبی استفاده شود.مثال زیر را در نظر بگیرید:
فرض کنید میخواهیم فهرست بزرگترین بانکهای جهان بر اساس ارزش بازار را از لینک زیر استخراج کنیم:
1. URL = 'https://en.wikipedia.org/wiki/List_of_largest_banks'
ما میتوانیم از تابع pandas.read_html() در پایتون برای استخراج مستقیم تمامی جداول موجود در صفحه وب استفاده کنیم. (اسنپشاتی از صفحه وب در زیر وجود دارد).
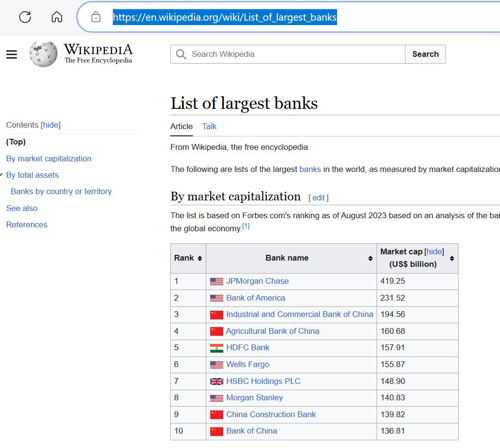
میتوانیم ببینیم که جدول مورد نیاز، اولین جدول در صفحه وب است.
توجه: این یک صفحه وب زنده است و ممکن است در طول زمان بهروزرسانی شود. تصاویر اشارهشده در بالا در نوامبر ۲۰۲۳ ثبت شدهاند. با این حال، فرآیند استخراج دادهها یکسان باقی میماند.
میتوانیم خطوط کد زیر را برای استخراج جدول مورد نیاز از صفحه وب اجرا کنیم:
1.import pandas as pd
2. URL = 'https://en.wikipedia.org/wiki/List_of_largest_banks'
3. tables = pd.read_html(URL)
4. df = tables[0]
5. print(df)
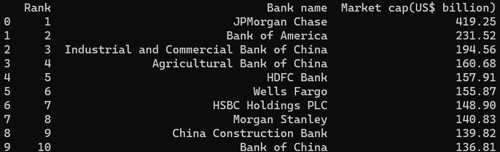
این کار، جدول مورد نیاز را به عنوان یک دیتافریم (dataframe) به نام df استخراج خواهد کرد. خروجی دستور print به شکل زیر نمایش داده میشود.
اگرچه این روش راحت است، اما محدودیتهای خاص خود را دارد. اولاً، صفحات وب ممکن است محتوایی داشته باشند که به عنوان جدول در آنها ذخیره شده است، اما در ظاهرِ صفحه وب به شکل جدول نمایش داده نشوند.
برای مثال، URL زیر را در نظر بگیرید که فهرست کشورها بر اساس تولید ناخالص داخلی (اسمی) را نشان میدهد:
1. URL = 'https://en.wikipedia.org/wiki/List_of_countries_by_GDP_(nominal)'
تصاویر موجود در این صفحه وب نیز در قالب جدولی ذخیره شدهاند. اسنپشاتی از صفحه وب در زیر به اشتراک گذاشته شده است:
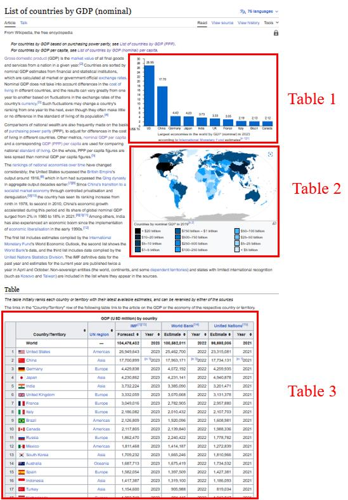
دوماً، محتویات جداول در صفحات وب ممکن است شامل عناصری مانند متنهای دارای لینک (hyperlink text) و سایر نشانگرها باشند که با استفاده از روش pandas نیز مستقیماً اسکریپ میشوند. این امر ممکن است به نیاز برای پاکسازی بیشتر دادهها (Data Cleaning) منجر شود. نگاهی دقیقتر به جدولِ ۳ در این صفحه نشان میدهد که متنهای لینکدارِ بسیاری وجود دارند که توسط تابع pandas نیز به عنوان اطلاعات در نظر گرفته خواهند شد.
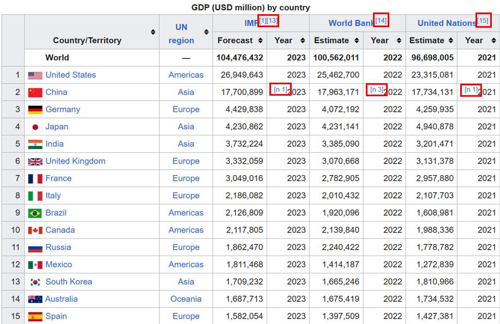
میتوانیم این جدول را با استفاده از کد نشان داده شده در زیر استخراج کنیم:
1. import pandas as pd
2. URL = 'https://en.wikipedia.org/wiki/List_of_countries_by_GDP_(nominal)'
3. tables = pd.read_html(URL)
4. df = tables[2] # the required table will have index 2
5. print(df)
در خروجی دستور print، مشاهده خواهید کرد که متنهای دارای لینک نیز در خروجی کد حفظ شدهاند.
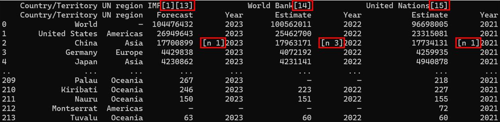
همچنین، لازم به ذکر است که این روش منحصراً فقط برای استخراج دادههای جدولی عمل میکند. کتابخانه BeautifulSoup همچنان روش پیشفرض برای استخراج هر نوع اطلاعاتی از صفحات وب محسوب میشود.
برای مشاهده کامل این قسمت، دوره را تهیه کنید
پس از خرید، به همه قسمتهای این دوره دسترسی خواهید داشت.